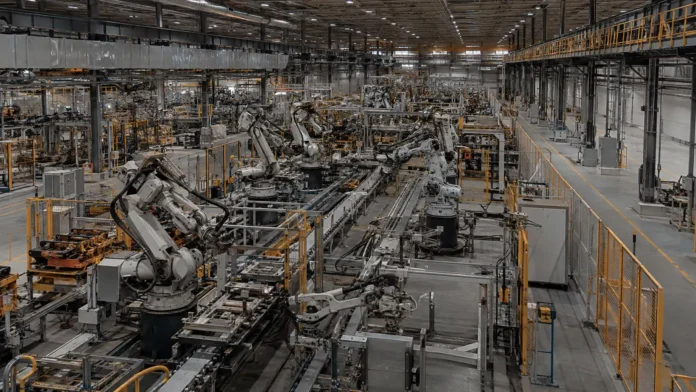
Kina kan ha byggt upp en fördel i AI-racet som inte handlar om de snabbaste chippen eller den bästa språkmodellen. En ny amerikansk rapport pekar i stället på landets enorma tillgång till data från fabriker, robotar, fordon och annan fysisk verksamhet. Det är information som inte går att skrapa från det öppna internet och som kan bli avgörande när nästa generation AI ska lära sig att fungera i den verkliga världen.
En ny rapport från staben vid den kongressanknutna U.S.-China Economic and Security Review Commission, USCC, sätter fokus på en mindre uppmärksammad del av konkurrensen mellan Kina och USA.
Kina har under flera år försökt göra data till en ekonomisk tillgång på ungefär samma sätt som kapital, arbete och teknik. Nu varnar rapportförfattarna för att landets stora industriella bas kan ge kinesiska företag tillgång till datamängder som blir allt mer värdefulla för avancerad AI.
Det gäller särskilt robotik, autonoma fordon och andra system som måste förstå och agera i den fysiska världen.
Den viktigaste datan finns inte på internet
Mycket av den AI-utveckling som hittills fått störst uppmärksamhet har byggt på enorma mängder text, bilder och annan information som kunnat samlas in från internet.
Men den typen av data löser inte alla problem.
En robot som ska arbeta i en fabrik måste lära sig hur föremål faktiskt rör sig, hur maskiner reagerar och vad som händer när någonting går fel. Ett självkörande fordon behöver information från verkliga trafiksituationer. Industriella AI-system behöver förstå maskiner, temperaturer, vibrationer, produktionsstopp och tusentals andra signaler som aldrig hamnar på en publik webbsida.
Det är just denna typ av data som USCC lyfter fram i sin nya rapport om Kinas datastrategi.
Rapporten bedömer att företagsdata och fysisk data kan bli allt viktigare när mängden lättillgängligt träningsmaterial från internet inte längre räcker för att driva utvecklingen lika långt framåt.
Kinas fabriker kan bli enorma datamaskiner
Det är här Kinas industriella skala blir särskilt intressant.
Landet installerade omkring 295 000 industrirobotar under 2024, vilket motsvarade mer än hälften av alla nya installationer i världen. Det samlade beståndet av industrirobotar i Kina passerade samtidigt två miljoner.
Varje robot, produktionslinje, sensor och uppkopplad maskin kan i teorin skapa nya datapunkter om hur verkliga arbetsmoment utförs.
Det skapar en möjlig självförstärkande effekt:
Fler robotar ger mer verklig data. Mer data kan ge bättre AI-system. Bättre AI kan i sin tur göra robotarna mer användbara och leda till ännu större användning.
Kinas styrka inom industri kan därmed bli en styrka även inom AI.
Det kompletterar en annan kinesisk strategi som Hurbra tidigare har beskrivit i Öppna AI-modeller: Så pressar Kina USA, där kinesiska utvecklare försöker sprida modeller snabbt och bygga stora ekosystem kring dem.
Kina försöker göra data till en handelsvara
Den kinesiska satsningen är inte ny.
Redan 2020 klassades data som en produktionsfaktor i Kina. Därefter har landet byggt upp databörser, regler för datahandel och system för att värdera och kategorisera datatillgångar.
Tanken är att information som tidigare legat isolerad hos företag och myndigheter lättare ska kunna användas, säljas och kombineras.
USCC pekar på att andelen datatransaktioner som går genom officiella databörser har vuxit kraftigt sedan början av 2020-talet. Kinesiska myndigheter har dessutom uppgett att landet byggt upp hundratals petabyte med så kallade högkvalitativa dataset.
Men mängden data säger inte allt.
Dåligt strukturerad, duplicerad eller felaktig information är betydligt mindre värdefull för AI än väl märkt och relevant data. Rapporten beskriver också problem med otydligt ägande, varierande kvalitet och företag som inte vill lämna ifrån sig sina mest värdefulla dataset.
Kinas fördel är därför inte att all industriell information automatiskt finns samlad i en enda enorm databas.
Den potentiella styrkan ligger snarare i kombinationen av mycket stor industriell aktivitet och en statlig ambition att göra mer av datan användbar och möjlig att handla med.
Robotik och självkörande fordon särskilt viktiga
Skillnaden mellan dagens generativa AI och nästa generations så kallade fysiska AI är central.
En språkmodell kan tränas på text och bilder. En humanoid robot som ska vika tvätt, flytta komponenter eller arbeta tillsammans med människor behöver däremot lära sig hur den fysiska världen fungerar.
Detsamma gäller autonoma fordon.
Det behövs verkliga exempel på bland annat rörelser, hinder, misstag och ovanliga situationer. Ju fler maskiner som används, desto större kan tillgången till sådana erfarenheter bli.
Det är därför en enorm produktionssektor kan bli en AI-tillgång även om den inte från början byggdes med AI som huvudsyfte.
Även militär AI finns med i bilden
USCC kopplar Kinas bredare datastrategi även till underrättelse- och militär kapacitet.
Tekniken bakom robotik och fysisk AI har ofta både civila och militära användningsområden. Framsteg inom exempelvis autonom navigation, sensortolkning och robotstyrning kan därför få betydelse långt utanför fabrikerna.
Det betyder däremot inte att all kommersiell kinesisk industridata automatiskt används av militären.
Rapportens poäng är snarare att en starkare infrastruktur för att samla och använda data kan stärka flera delar av Kinas tekniska kapacitet samtidigt.
USA leder fortfarande på flera områden
Den amerikanska rapporten innebär inte att Kina redan har tagit över ledningen i AI-racet.
USA har fortfarande stora fördelar inom bland annat ledande AI-modeller, privata investeringar, avancerade chip och flera av världens största AI-företag.
Kina har däremot minskat avståndet inom modeller samtidigt som landets industriella bas ger andra möjligheter än de amerikanska teknikbolagens.
Det gör konkurrensen svårare att mäta med en enda topplista över vilken språkmodell som just nu presterar bäst.
Framtidens AI-kapplöpning kan i stället avgöras av flera olika resurser samtidigt: chip, energi, kapital, modeller och data.
Europa försöker frigöra sin egen industridata
Frågan är högst relevant även för Sverige och resten av Europa.
EU har redan börjat behandla högkvalitativ data som en strategisk resurs för AI. Genom Data Act och den nya Data Union-strategin försöker unionen göra mer information från bland annat uppkopplade produkter och industrimaskiner tillgänglig.
Europa sitter samtidigt på en stor industriell bas inom fordon, verkstad, energi och avancerad tillverkning.
Det innebär att även europeiska företag kan ha några av de dataset som blir mest värdefulla när AI flyttar från skärmen och ut i den fysiska ekonomin.
Skillnaden ligger till stor del i modellen. Kina försöker driva fram en mer statsstyrd datamarknad, medan EU försöker kombinera ökad tillgång med regler om bland annat integritet, företagshemligheter och användares rättigheter.
Den bredare kampen mellan USA och Kina har redan fått konkreta följder för Sverige genom satsningar på chip, mineraler och AI-infrastruktur. Hurbra har tidigare beskrivit det i Pax Silica: Sverige dras in i USA:s AI-kamp mot Kina.
Nu växer ytterligare en front fram.
AI-racet handlar inte längre bara om chip
Under de senaste åren har mycket av geopolitiken kring AI kretsat kring avancerade halvledare och vem som får tillgång till dem.
Den nya rapporten pekar på att nästa bristvara kan vara betydligt svårare att exportkontrollera.
En fabrik kan producera data varje sekund. Ett fordon kan registrera nya trafiksituationer varje kilometer. En robot kan generera information varje gång den försöker utföra ett arbetsmoment.
Det är erfarenheter från den verkliga världen som inte går att kopiera genom att ladda ned ännu en samling texter från internet.
Om fysisk AI blir nästa stora steg kan därför frågan om vem som har flest chip behöva kompletteras med en annan:
Vem har tillgång till mest av den data som lär maskiner hur världen faktiskt fungerar?